语料创新生态联盟在京成立
2026-09-30 09:34:57
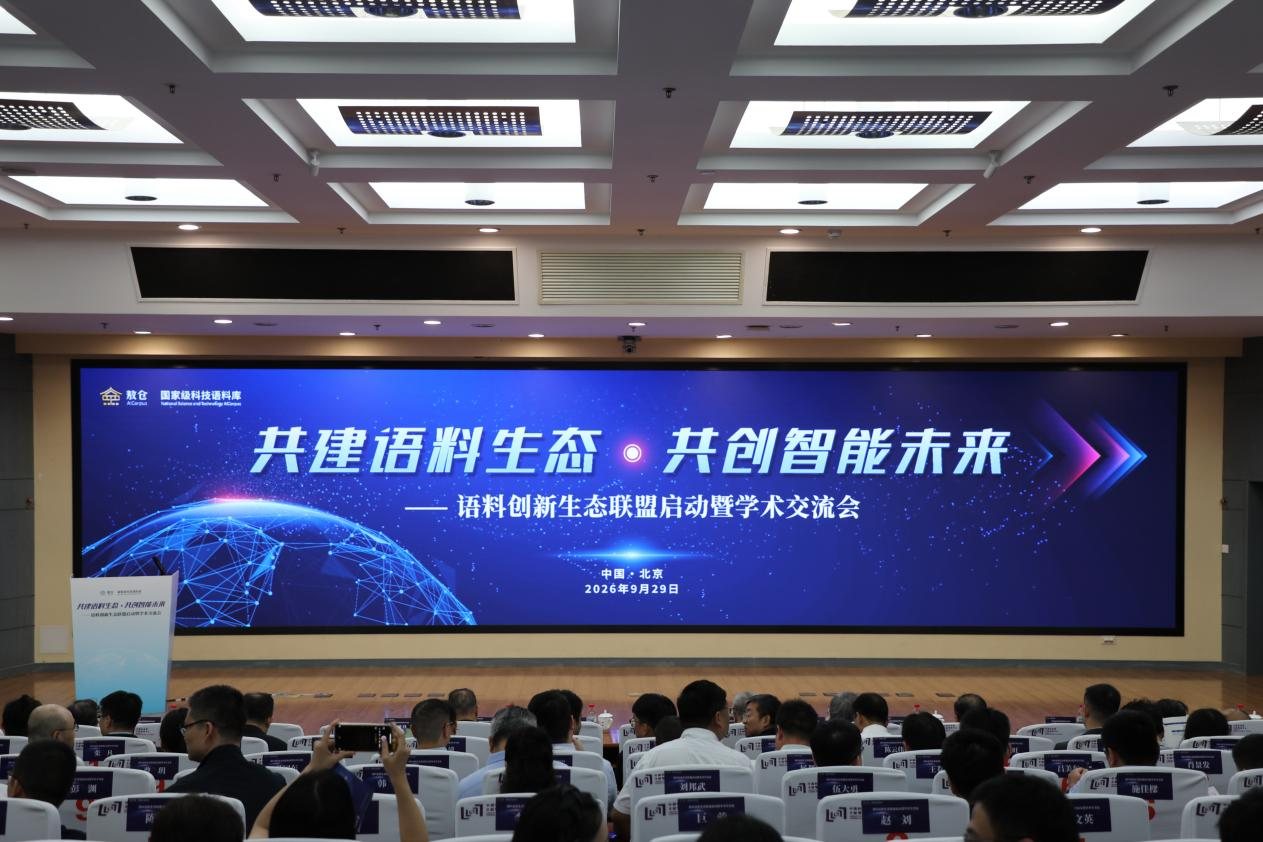
9月29日,由中国科学院文献情报中心发起、以“共建语料生态·共创智能未来”为主题的“语料创新生态联盟启动暨学术交流会”在北京举行。全国性语料创新生态联盟宣布启动。中国科学院文献情报中心代表敖仓·科技语料库分别与语料应用关键机构、国家人工智能应用中试基地签署合作协议,并为共建单位授牌,共同推动科技语料与科研、产业应用场景衔接。
中国科学院科技基础能力局局长卢方军表示,科技语料连接原始科研资源与人工智能模型,是支撑模型训练、科学推理和知识发现的重要基础。建设高质量科技语料,已经成为发展科学智能、提升人工智能专业能力的重要基础性工作。但目前,高价值科技资源仍较为分散,资源汇聚与授权机制有待完善,标准规范、专业加工、质量评价和安全流通能力仍需加强,语料供给与模型研发、科研任务及产业场景之间也需要建立更加紧密的协同机制。这些问题难以依靠单一机构解决,需要语料供给方、技术研发方和应用需求方共同参与、协同推进。
中国科学院文献情报中心党委书记李猛力说,全球人工智能竞争正由单一技术和模型能力的比拼,向模型、算力、数据与应用生态协同发展的综合竞争深化。加快构建自主可控、开放协同、安全可信的语料创新生态,是夯实我国人工智能发展基础、支撑高水平科技自立自强的重要举措。
联盟发起人、中国工程院院士孙凝晖表示,联盟要推动科技语料资源和加工能力的基础设施化,建设国家高质量科技语料资源的战略保障基地、国家智能就绪语料集成服务的协同枢纽。
据了解,联盟依托中国科学院以及全国科研与产业体系优势,首批50家共建单位覆盖国家实验室、科研院所与国家级科学数据与文献资源机构,地方政府以及人工智能、数据基础设施、出版与知识服务等领域骨干单位,语料运营企业以及人工智能领域知名投资机构,贯通科技语料资源供给、技术研发、平台建设、模型训练与行业应用全链条,旨在推动资源供给、技术研发和行业应用等关键环节有效衔接。
标准规范是保障科技语料规模化建设和高质量应用的关键基础支撑。会议上,围绕科技语料建设、工具平台、业务流程和运营管理等重点环节的五类42项科技语料标准集中发布。会议期间还发布了敖仓·语料社区服务平台,该平台以“面向语料创新生态,建设开放协同的语料社区”为目标,汇聚科研机构、高校、企业、开发者等多方力量,围绕“开放贡献、需求反馈、共享使用、协同创新”,支持多主体便捷贡献语料、工具与知识,收集并响应科研与产业的多样化需求,推动产学研用深度协同,激发语料数据的更大价值。国际化英文学术期刊Data Express in AI Corpus(《人工智能语料研究》)也在会上宣布创刊。(经济日报记者 沈慧)